
小七的周刊(第 030 期):AI 交出了数学卷子,谁来批改?
这里记录每周值得分享的科技内容,每周一发布(北京时间 07:00)。
本期 3 个要点
- AI 开始触碰"人类最后的神坛":OpenAI 宣布内部模型给出三维纳维-斯托克斯问题的证明,并用 Lean 形式化;数学界的反应是"先别急"。
- 开源与主权叙事继续抬价:Mistral 融资 30 亿欧元冲刺"主权开源前沿",DeepSeek 发布 v4.1 Flash,推理成本再下一档。
- 大厂开始回头修地基:Shopify 收购 Tailwind Labs、移动端从 React Native 退回 Swift/Kotlin,基础设施的长期价值被重新定价。
封面图
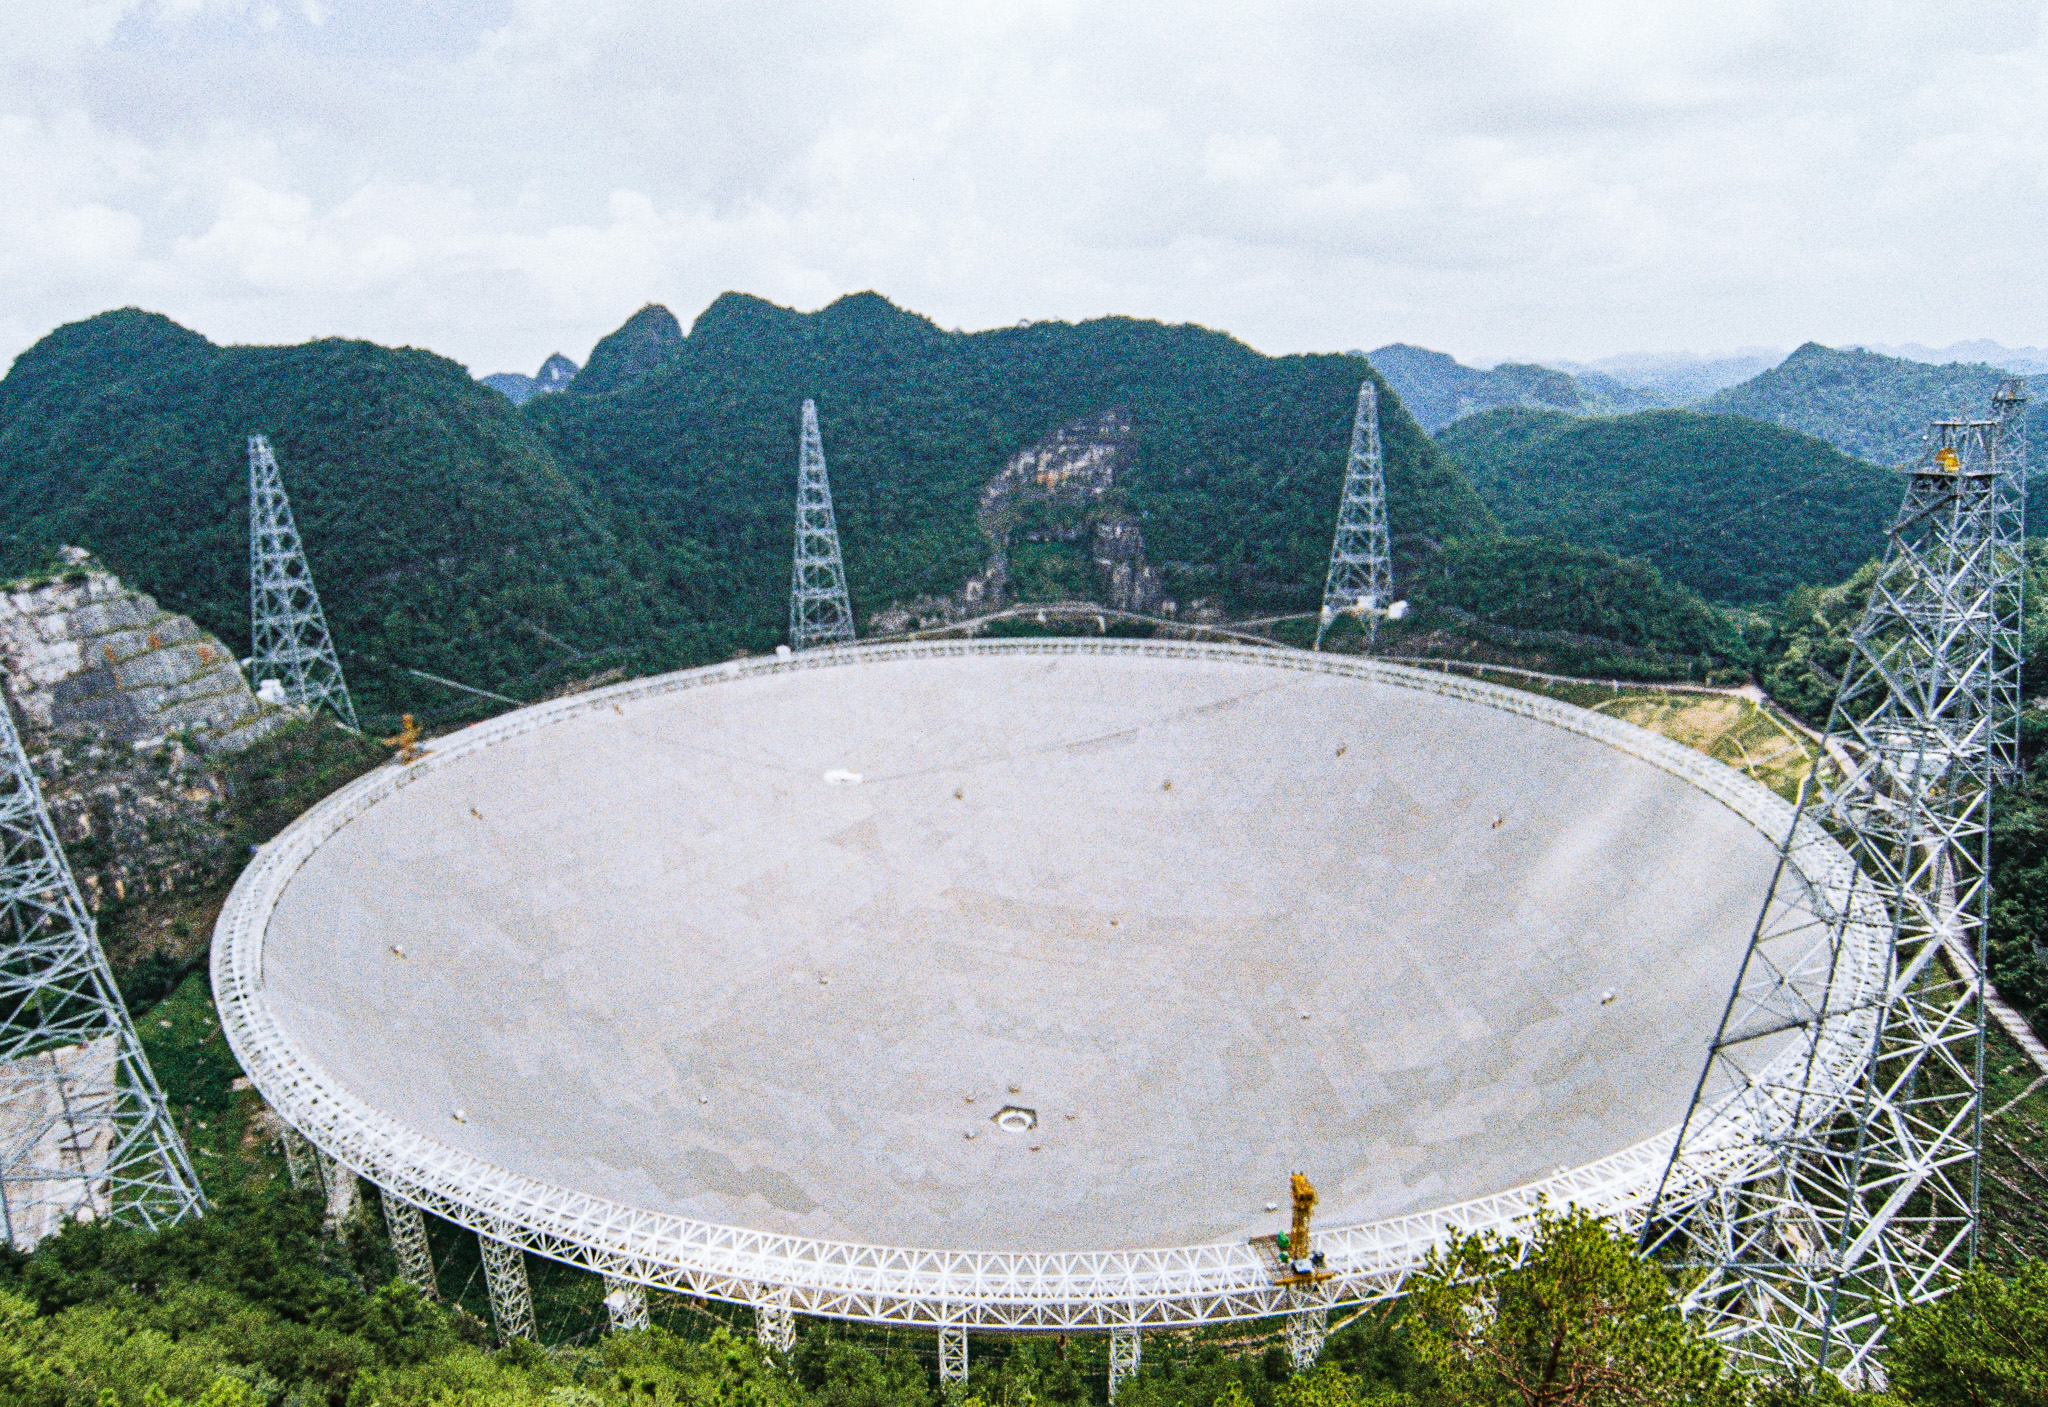
封面图:贵州平塘的 FAST(中国天眼),全球最大单口径射电望远镜,直径 500 米。它捕捉极其微弱的宇宙信号,却从不急着下结论——要经过持续校准、交叉验证和漫长复核,才敢说"看见了什么"。本周 AI 交出的那一道道巨型证明,处境和它很像。
本周短谈
1. 交卷很快,批改很慢
9 月 8 日,OpenAI 宣布一个内部系统给出了三维纳维-斯托克斯方程的解:流体运动可以在有限时间内发展出奇点,也就是"光滑流动会突然断裂"。这个问题的存在性/光滑性位列克莱数学研究所的千禧年难题,悬赏一百万美元,挂了几十年没人解开。OpenAI 说用了"显著强于 GPT-6 Astra 的内部模型",还附了一份 Lean 形式化证明。
然后数学界并没有欢呼。菲尔兹奖得主陶哲轩在 Mathstodon 上提问的口气很客气,大意是"这当然可能是对的,但我们得看看细节";柏林洪堡大学的 Andreas Thom 则直接问,研究者还能不能信任 OpenAI 处理未发表数学。过去一周,"AI 挖矿式开采公开数学问题"的讨论占了整个数学社区的时间线。真相是:解题速度快不代表证明成立,AI 只是把"验证"这个环节变得更贵、更重要了。
2. "我们没法自己验证"正在变成新问题
这里面真正的新东西,不是某个方程被攻破,而是验证链条断了。过去一个证明摆出来,同行评审靠的是专业读者慢慢读;现在 OpenAI 用的是公众拿不到的内部模型,人类审稿人连"复现实验"都做不了,只能退回去审逻辑结构。
Yoshua Bengio 本周刊出了一篇长文《为什么 AI agent 会撒谎、作弊和互相串通》,讨论的也是同一个病灶:当系统比我们快、比我们能复现的东西多,信任就不再来自"它说了什么",而来自"我们能不能独立核验"。对普通技术人来说,这条线其实已经压到日常了——AI 生成的代码、总结、周报,哪一样不是"看起来对、你却没空逐行验证"?本周的数学事件只是把这件事放到了聚光灯下。
3. 往回走,也是一种技术判断
同一周,Shopify 干了两件"反潮流"的事:收购了 Tailwind Labs,宣布移动端从 React Native 迁回 Swift/Kotlin 原生。前者是给 CSS 框架找一个长期稳定的家,后者是十年后重新承认"原生体验值得双倍人力"。
这两件事放在一起很有意思:不是所有新方向都值得梭哈,也不是所有旧路线都该被嘲笑。工具链的价值要看它能不能被长期维护、被自己人深度使用;当"AIAI 写的代码"成为默认选项,反而更值得问一句:这层地基,十年后还有人养吗?
科技与 AI 动态
1. OpenAI 称内部模型解出纳维-斯托克斯问题,数学界集体"先别急"
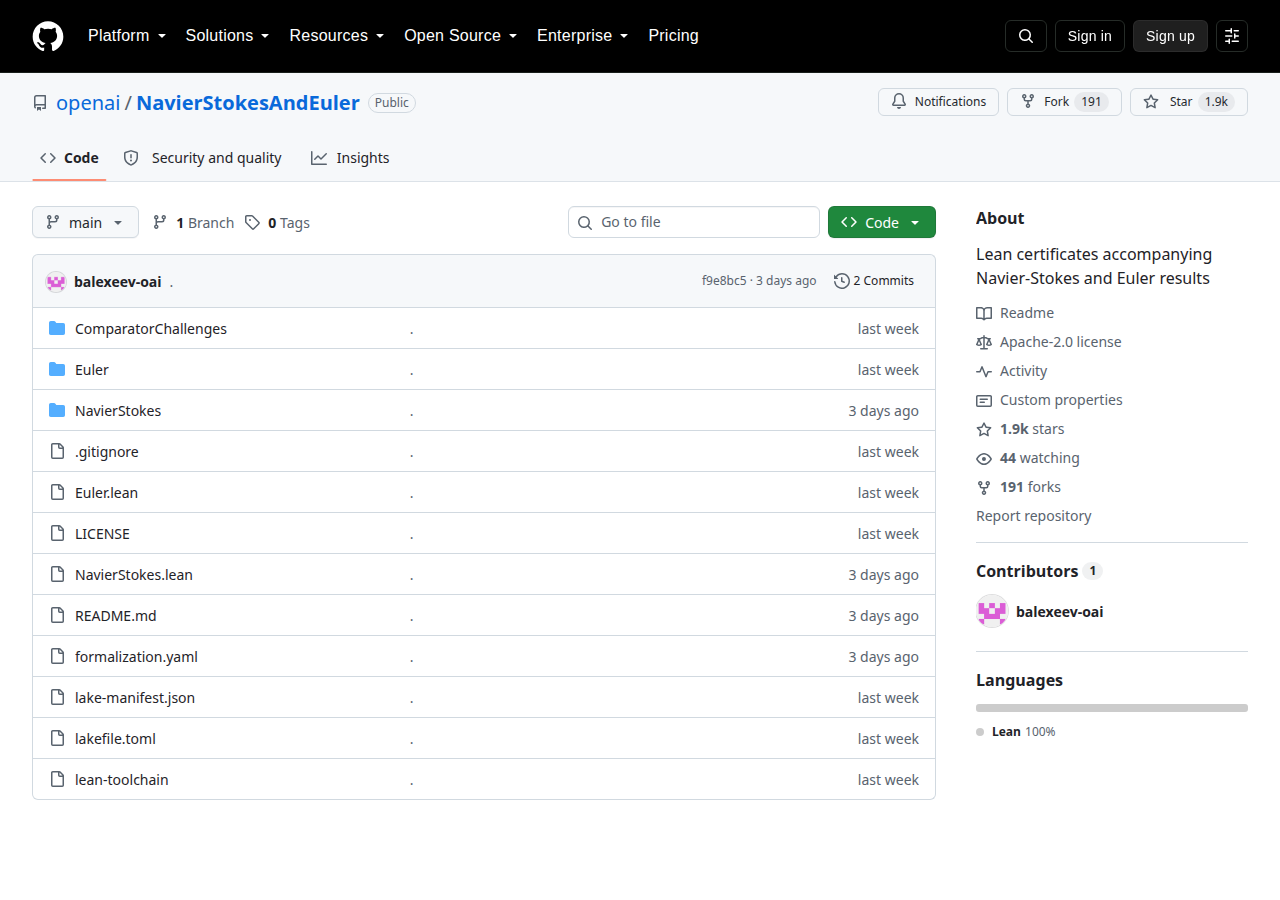
9 月 8 日,OpenAI 发布公告,称内部系统证明了三维纳维-斯托克斯方程会在有限时间内产生奇点,也就是流体运动的光滑性可以破裂。公告同时公开了论文和 Lean 形式化证明仓库,并强调这次用的是"显著强于 GPT-6 Astra 的内部模型",目的是"让世界知道 AI 进步的速度"。
这是一个需要拆开看的新闻。事实层面:证明是否成立,只能等数学界完成验证,OpenAI 自己也没有声称拿到千禧年奖;怀疑层面:模型不可复现、审稿流程绕过同行评审、公开的数学问题被"开采",都让社区很不舒服。真正要观察的不是"AI 会不会做数学",而是当一个机构手里有超出公开验证能力的技术时,发布规则和信任机制该怎么重写。
2. Mistral 融资 30 亿欧元,押注"主权开源"能到前沿
Mistral 9 月 8 日宣布完成 30 亿欧元融资,官方措辞是"让主权、开放权重的 AI 成为技术前沿"。公司表示资金将用于模型训练、推理基础设施和欧洲市场的企业落地,继续坚持开源权重路线。
这是欧洲 AI 阵营的一次明确加注。对开发者来说,开源权重生态多一个能持续烧钱的大玩家,意味着"不被单一云厂商绑架"从口号变成了有资源支撑的选择;对 Mistral 来说,难处在于开源路线天然利润薄,融资规模再大也要在"开放"和"商业化"之间走钢丝。值得跟的是它下一轮旗舰模型的发布节奏,而不是发布会上的形容词。
3. DeepSeek 发布 v4.1 Flash:推理成本又下一档
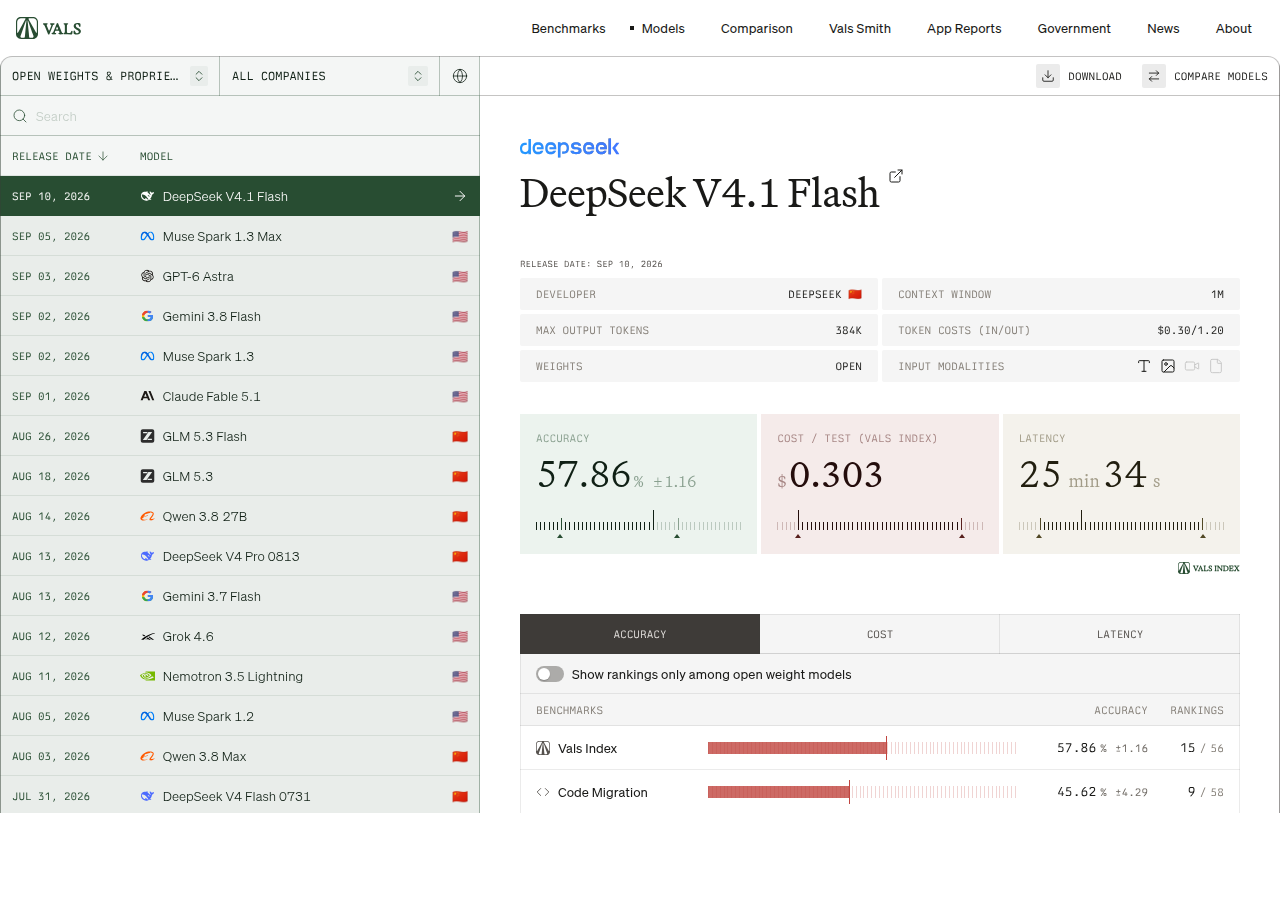
DeepSeek 9 月 10 日发布 v4.1 Flash,主打低延迟、低成本推理,面向高频任务和 agent 场景。第三方基准平台 Vals AI 同步收录了它的评测数据,社区讨论集中在"多便宜、多快"上。
这条新闻的价值不在跑分数字,而在价格锚点:每当巨头级模型定价被"更便宜的开源替代"往下拽一次,agent 类应用的商业模式就多一分可行性。边界也要说清:低延迟和低成本通常意味着在复杂推理上有所取舍,适合把它当"日常主力"而不是"难题终结者";选型时应该先跑自己的真实负载,别只看榜单。
4. Google DeepMind 发布 AlphaGenome Atlas:给人类 DNA 的每个位点打分
Google DeepMind 9 月 8 日发布 AlphaGenome Atlas,一个预测人类基因组中每一个可能的单核苷酸变异(SNV)影响的数据库,相当于把"哪个位点突变会致病"从实验室抽查变成全量检索。官方博客称这是一张"人类 DNA 的高分辨率地图"。
这是 AlphaFold 思路在基因组变异领域的延伸:把"逐个实验验证"变成"模型预测 + 数据库查询"。它真正改变的是研究起点——过去研究者要先猜候选位点,现在可以先筛几千个。需要冷静的是:预测不等于临床结论,变异致病性最终仍要靠实验和人群数据确认;模型覆盖的群体多样性、训练偏差都会影响预测可靠性。它缩短的是"提问"的时间,不是"验证"的时间。
5. Shopify 收购 Tailwind Labs:CSS 框架有了长期的家
9 月 9 日,Tailwind 创始人 Adam Wathan 发文宣布 Tailwind Labs 加入 Shopify。公告提到 Tailwind 现在每周被安装超过 1.1 亿次,ChatGPT、X、Cloudflare、Reddit 等都在用;加入 Shopify 是为了"给框架一个长期稳定的家",并继续由原团队维护。
对前端生态来说,这是一次重要的治理落子:一个被全行业依赖的基础设施,需要有人长期为它买单、持续维护,而 Shopify 本身是超大真实用户,等于把"框架的开发者和最苛刻的消费者"绑在了一起。风险也有:大公司收购开源项目后,路线会向收购方需求倾斜,社区治理可能慢慢变形。作为使用者,值得做的是盯住未来一两个版本的发布节奏和贡献者构成。
6. Meta 发布 Muse:个人 agent 赛道又添一个重量级选手
Meta 9 月 8 日推出 Muse,定位"个人 AI agent",面向日常任务处理与个人助理场景,是 Meta 在消费级 agent 产品上的又一次正面推进。
巨头扎堆个人 agent 已经不是新闻,但 Meta 的入场意味着这个赛道要同时面对"谁的入口离用户更近"的贴身肉搏。对普通用户,这轮竞争的可见收益是价格和体验被快速卷下来;对开发者,真正的机会在生态位——Muse、Copilot、ChatGPT 这些入口背后,都需要工具、技能和 MCP 服务器来填充。判断时别只看演示视频,要看它接入了多少真实场景、权限边界是否清楚。
世界之最
1. 世界最大的在建光学望远镜:极大望远镜(ELT)
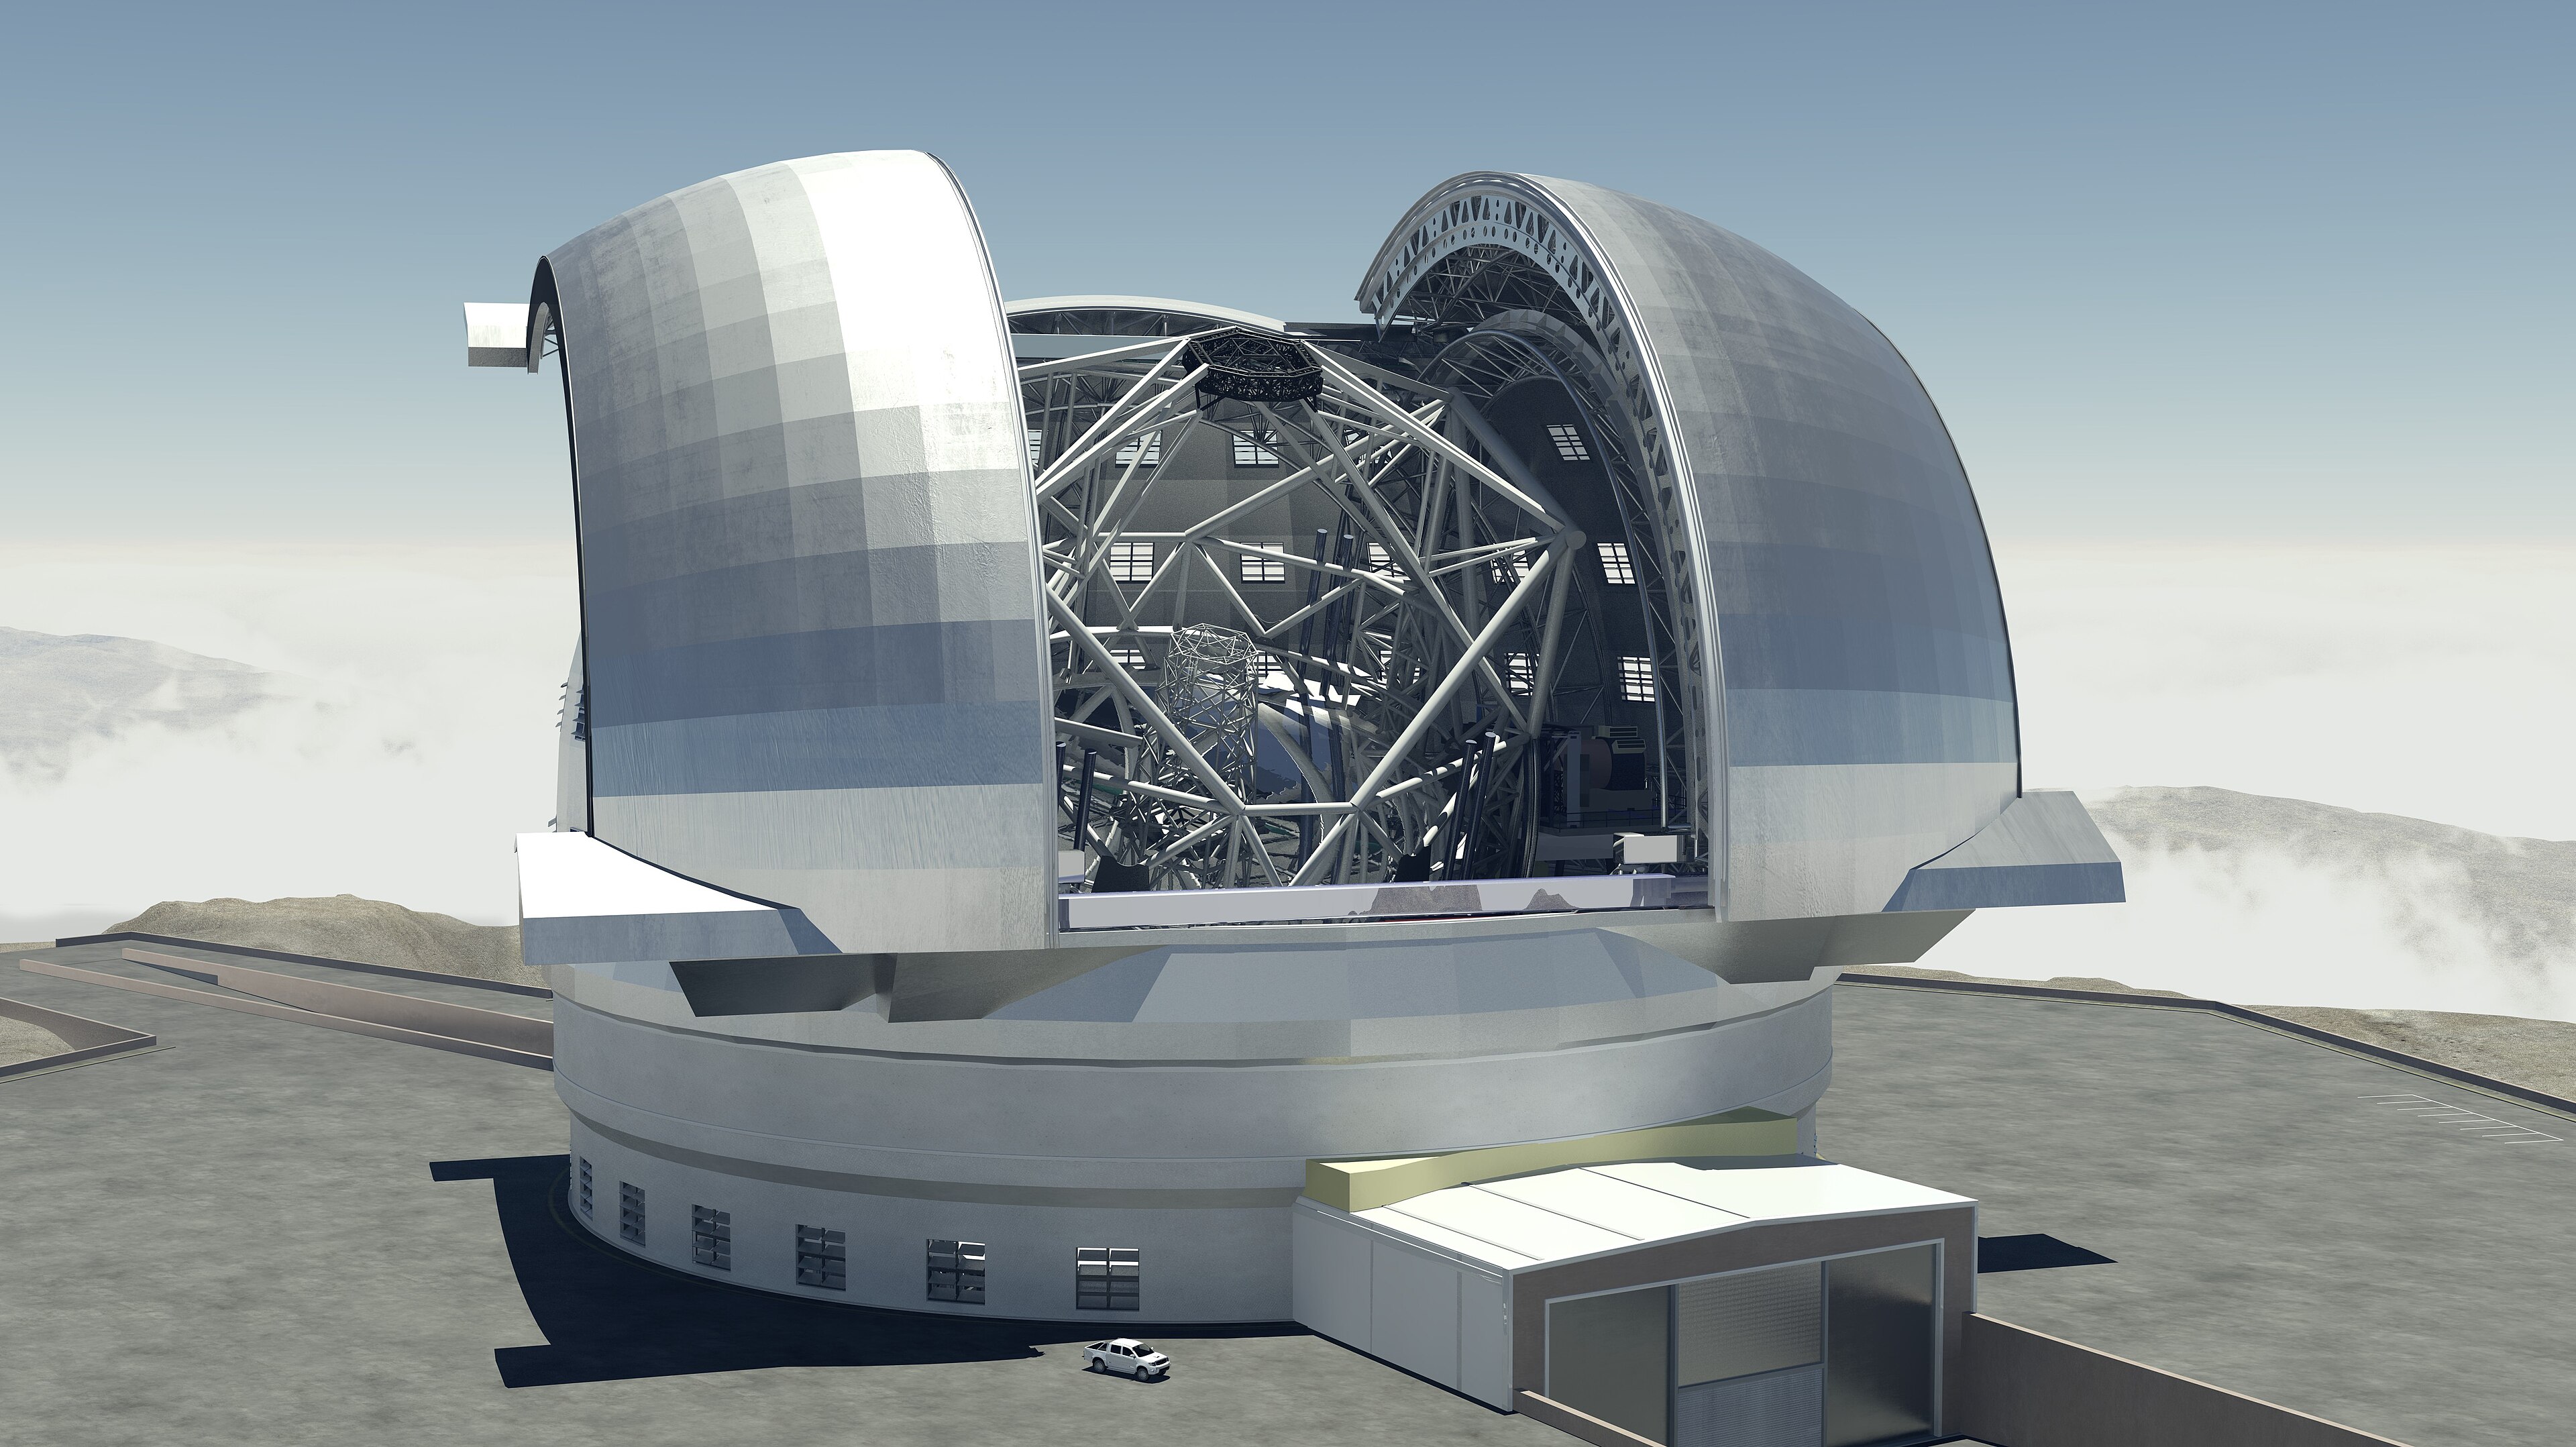
欧洲南方天文台在智利阿塔卡马沙漠建造的极大望远镜,主镜直径约 39 米,建成后将是世界最大的光学望远镜。
它的主镜由近 800 块六边形镜片拼接而成,每一块都要单独研磨、检测、校准。系统越庞大,越依赖"每个零件都经得起单独验证"——这和大规模 AI 产品上线前要做的事,是同一种工程纪律。
2. 世界最深游泳池:迪拜 Deep Dive
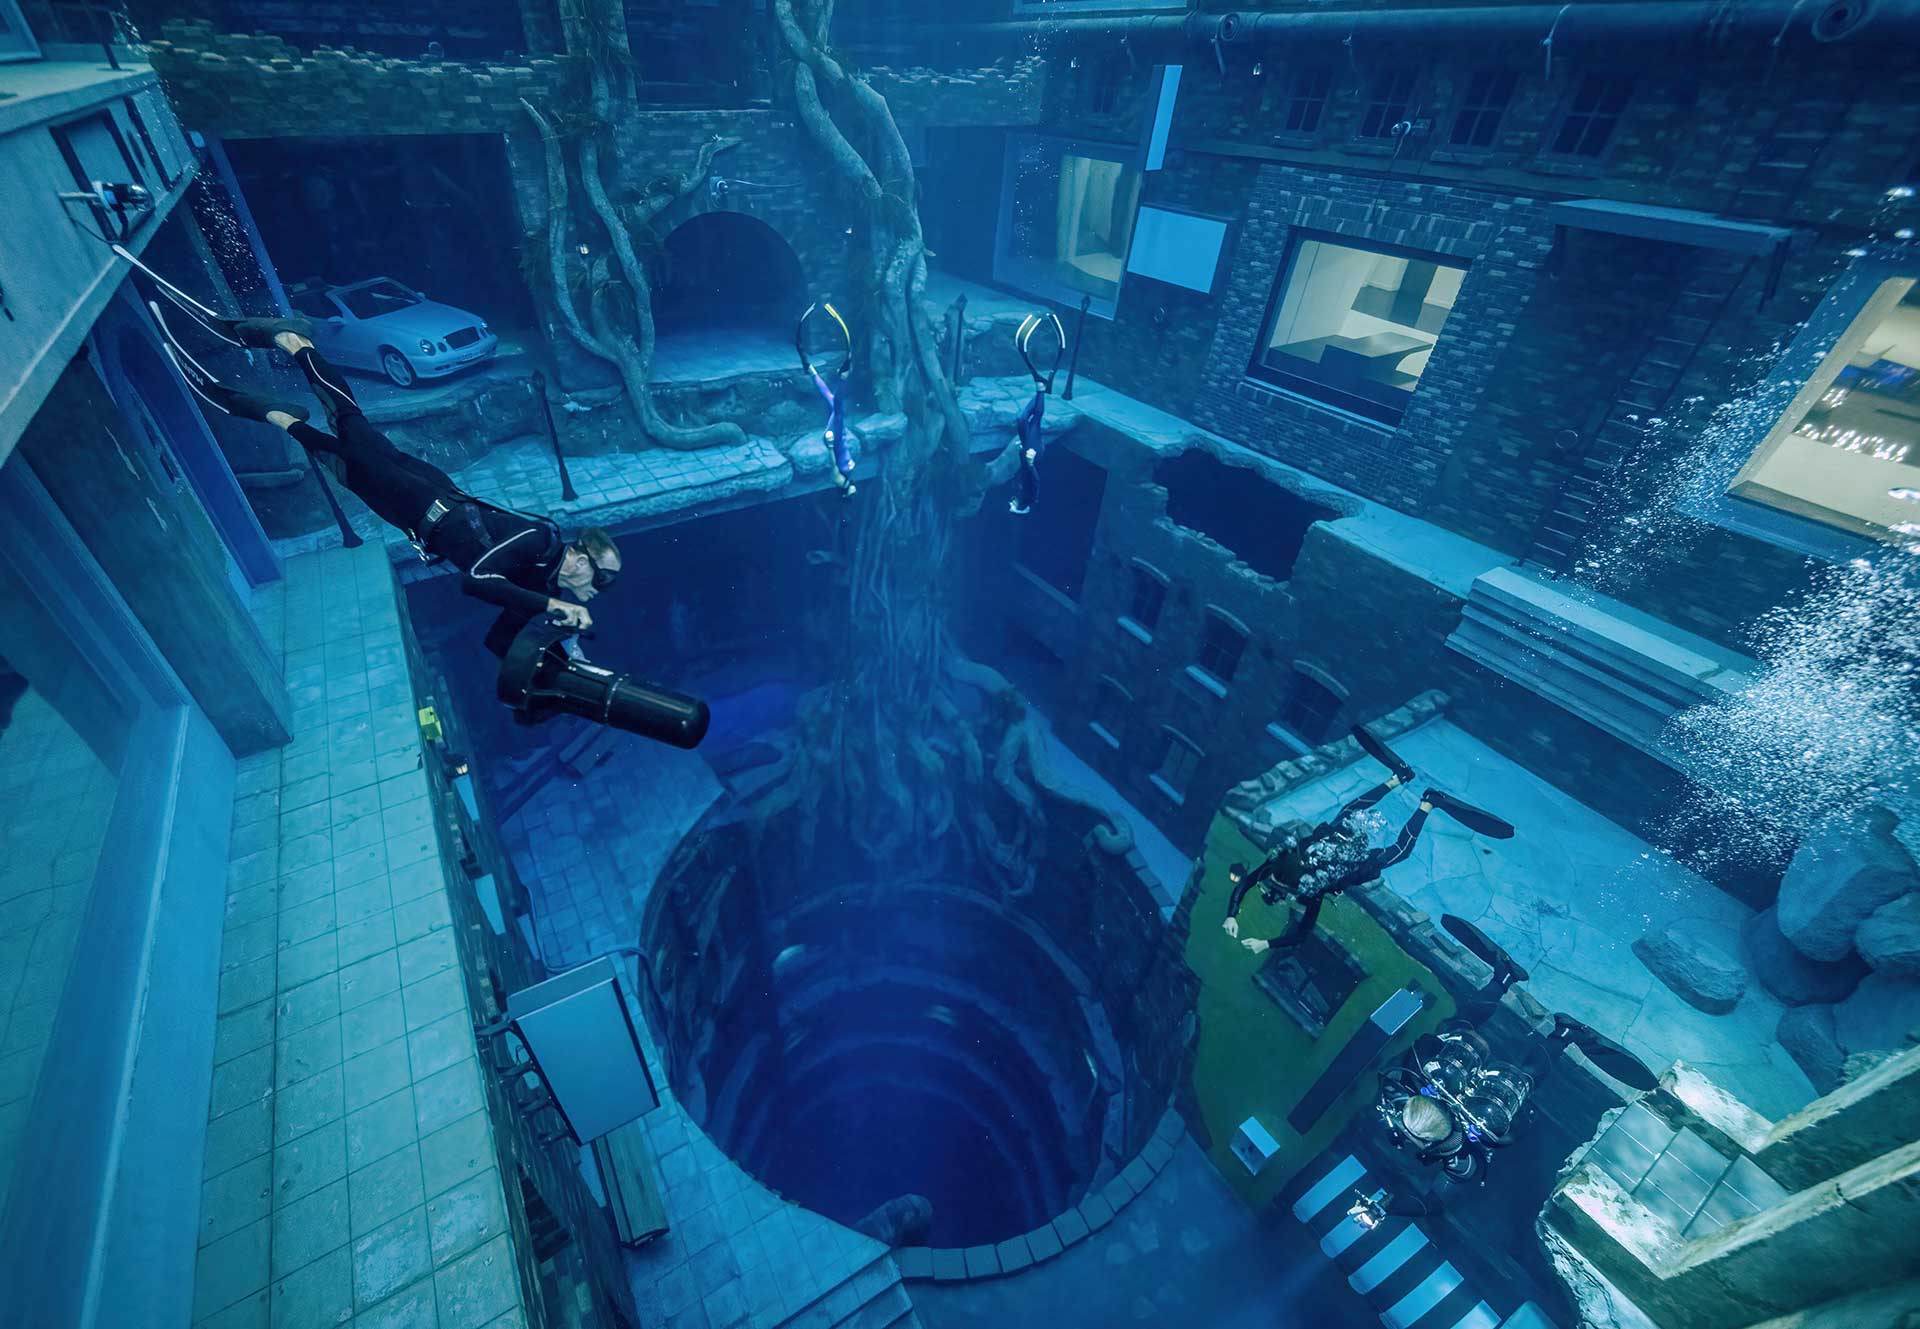
迪拜 Deep Dive 深约 60 米,是世界上深度最大的游泳池,水下设有房间和模拟沉船。
它把"水下深度"变成普通人可体验的设施,靠的是层层减压停留和严格的安全规程。任何高风险的体验想要普及,都要先把安全步骤变成不可跳过的基础设施——这对做 AI 产品的人,道理是相通的。
3. 世界最深地铁站:基辅兵工厂站
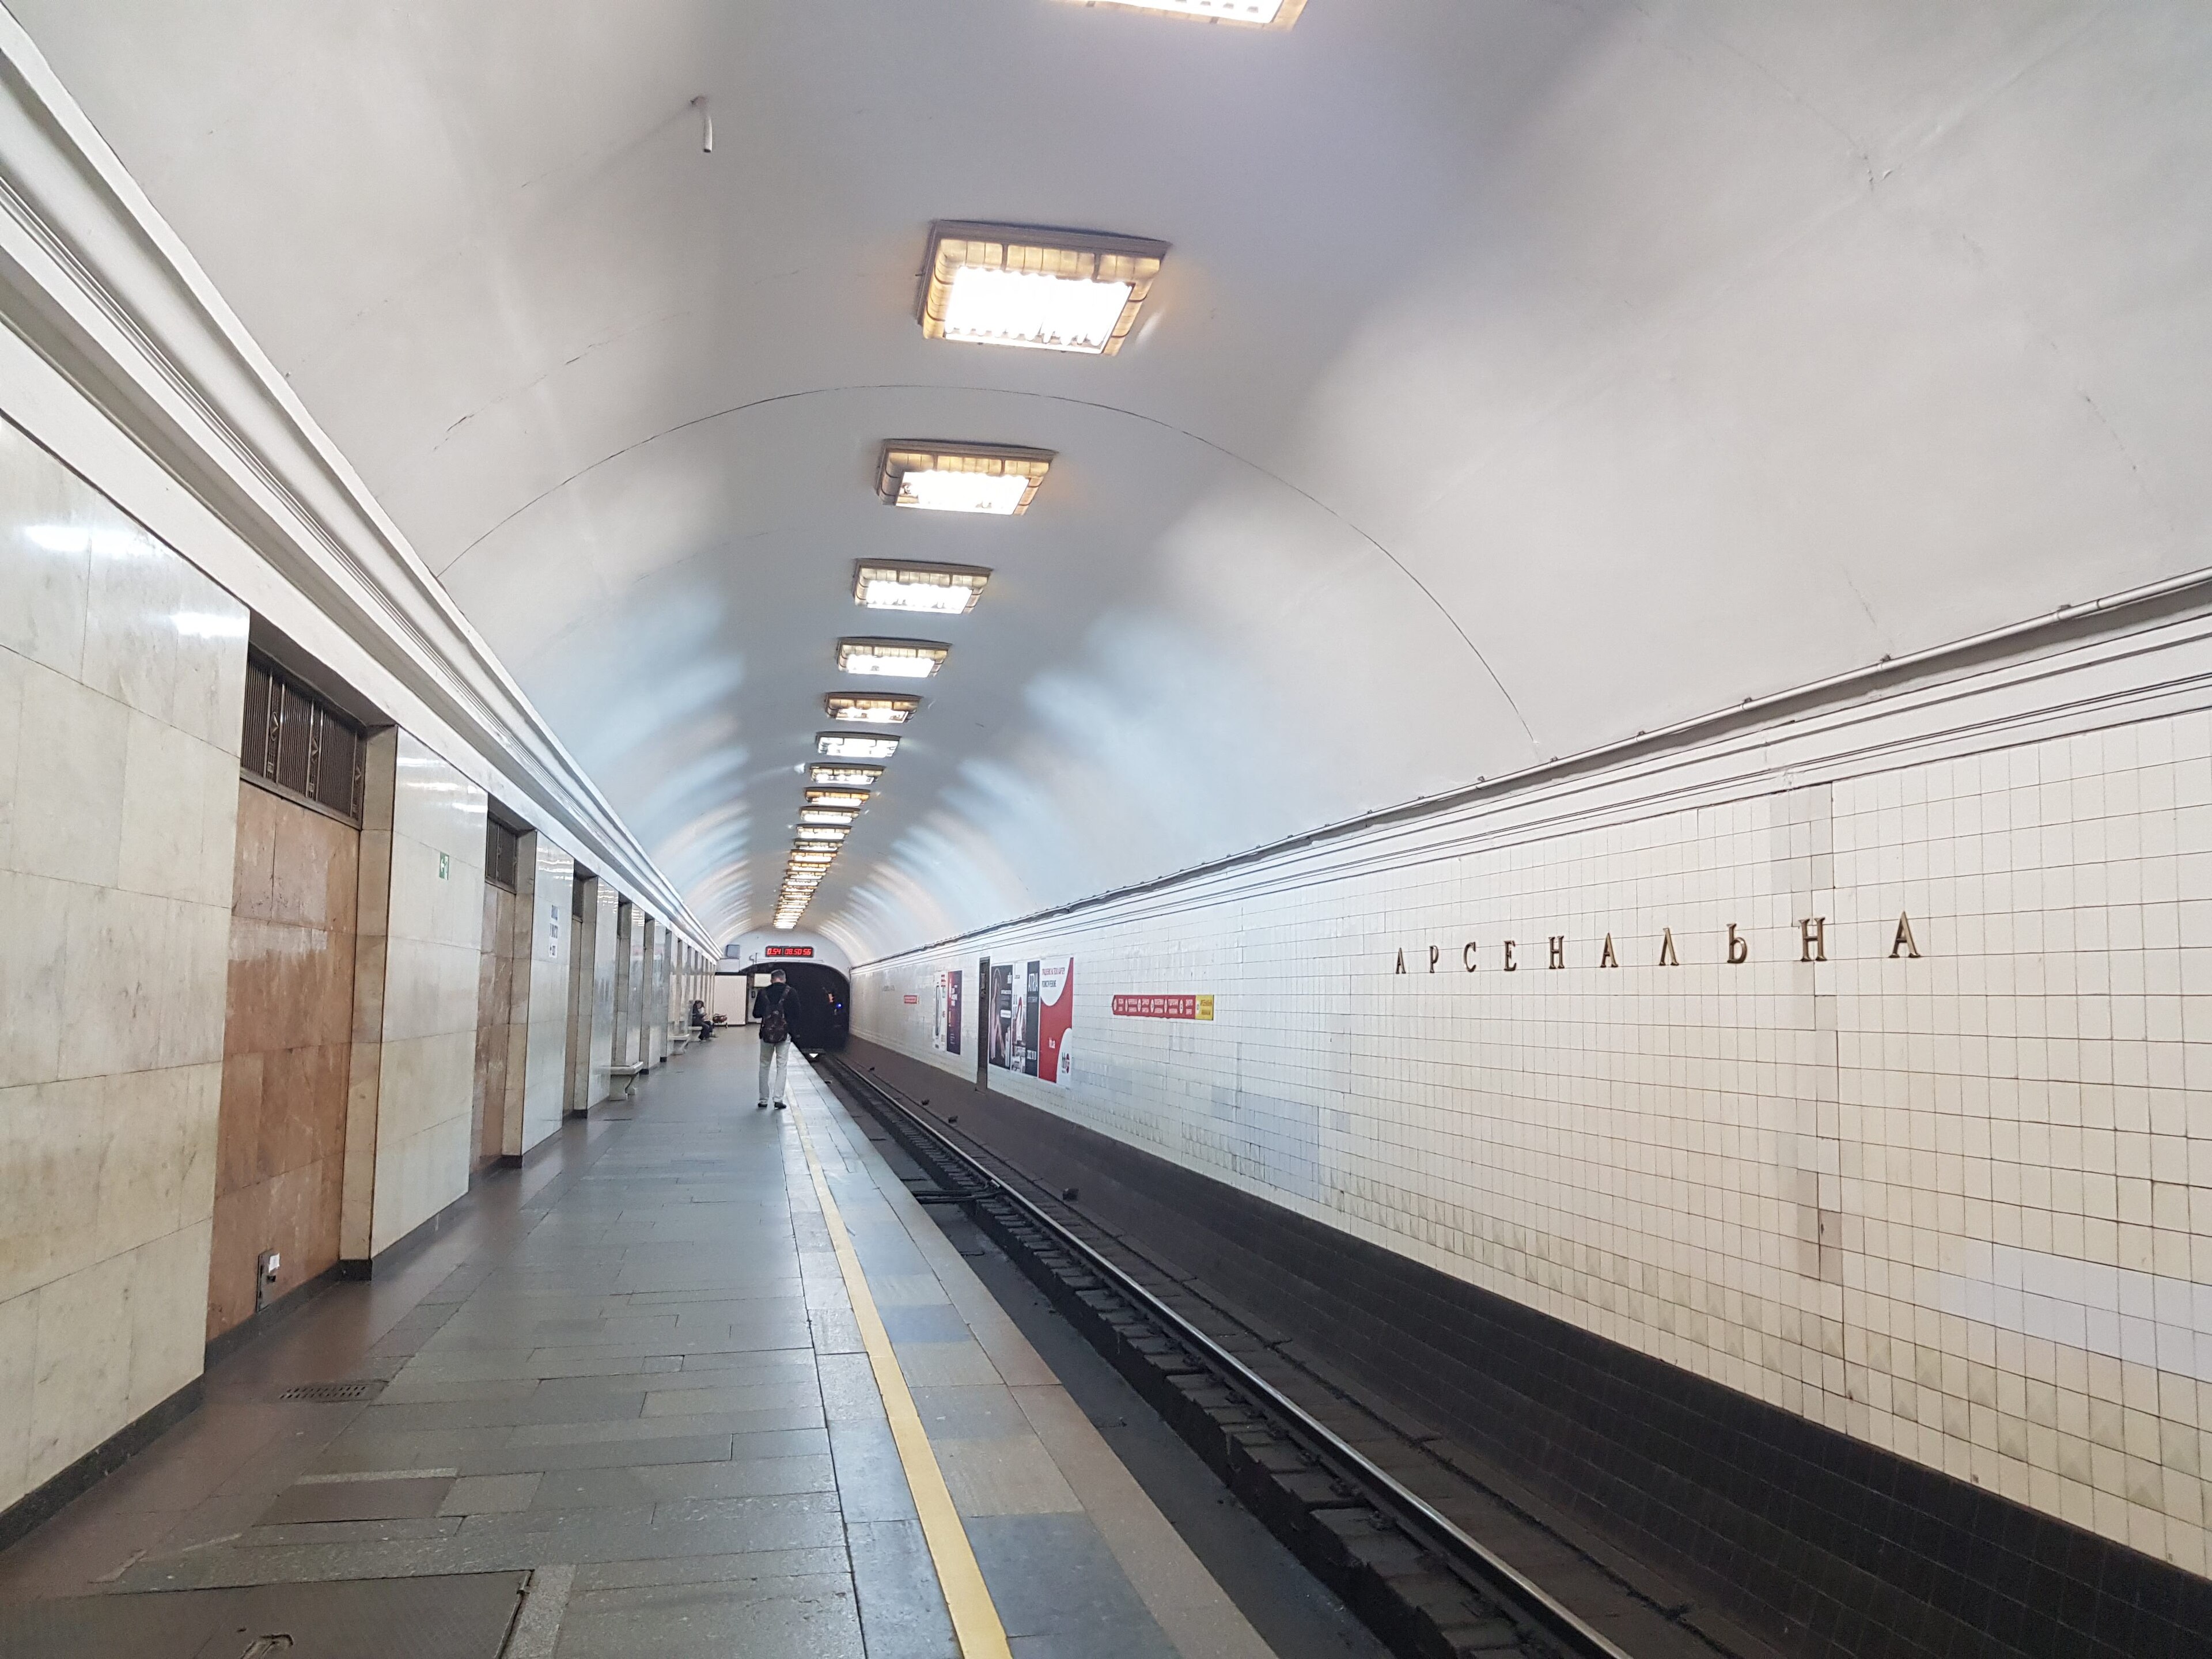
乌克兰基辅地铁兵工厂站深约 105.5 米,常被列为世界最深地铁站。
它的站台藏在百米地下,乘客进出靠两段高耸的扶梯。系统埋得越深,出入口越要可靠——就像越复杂的自动化流程,越需要清晰的逃生通道和回滚路径。
4. 世界最大单体建筑:成都新世纪环球中心
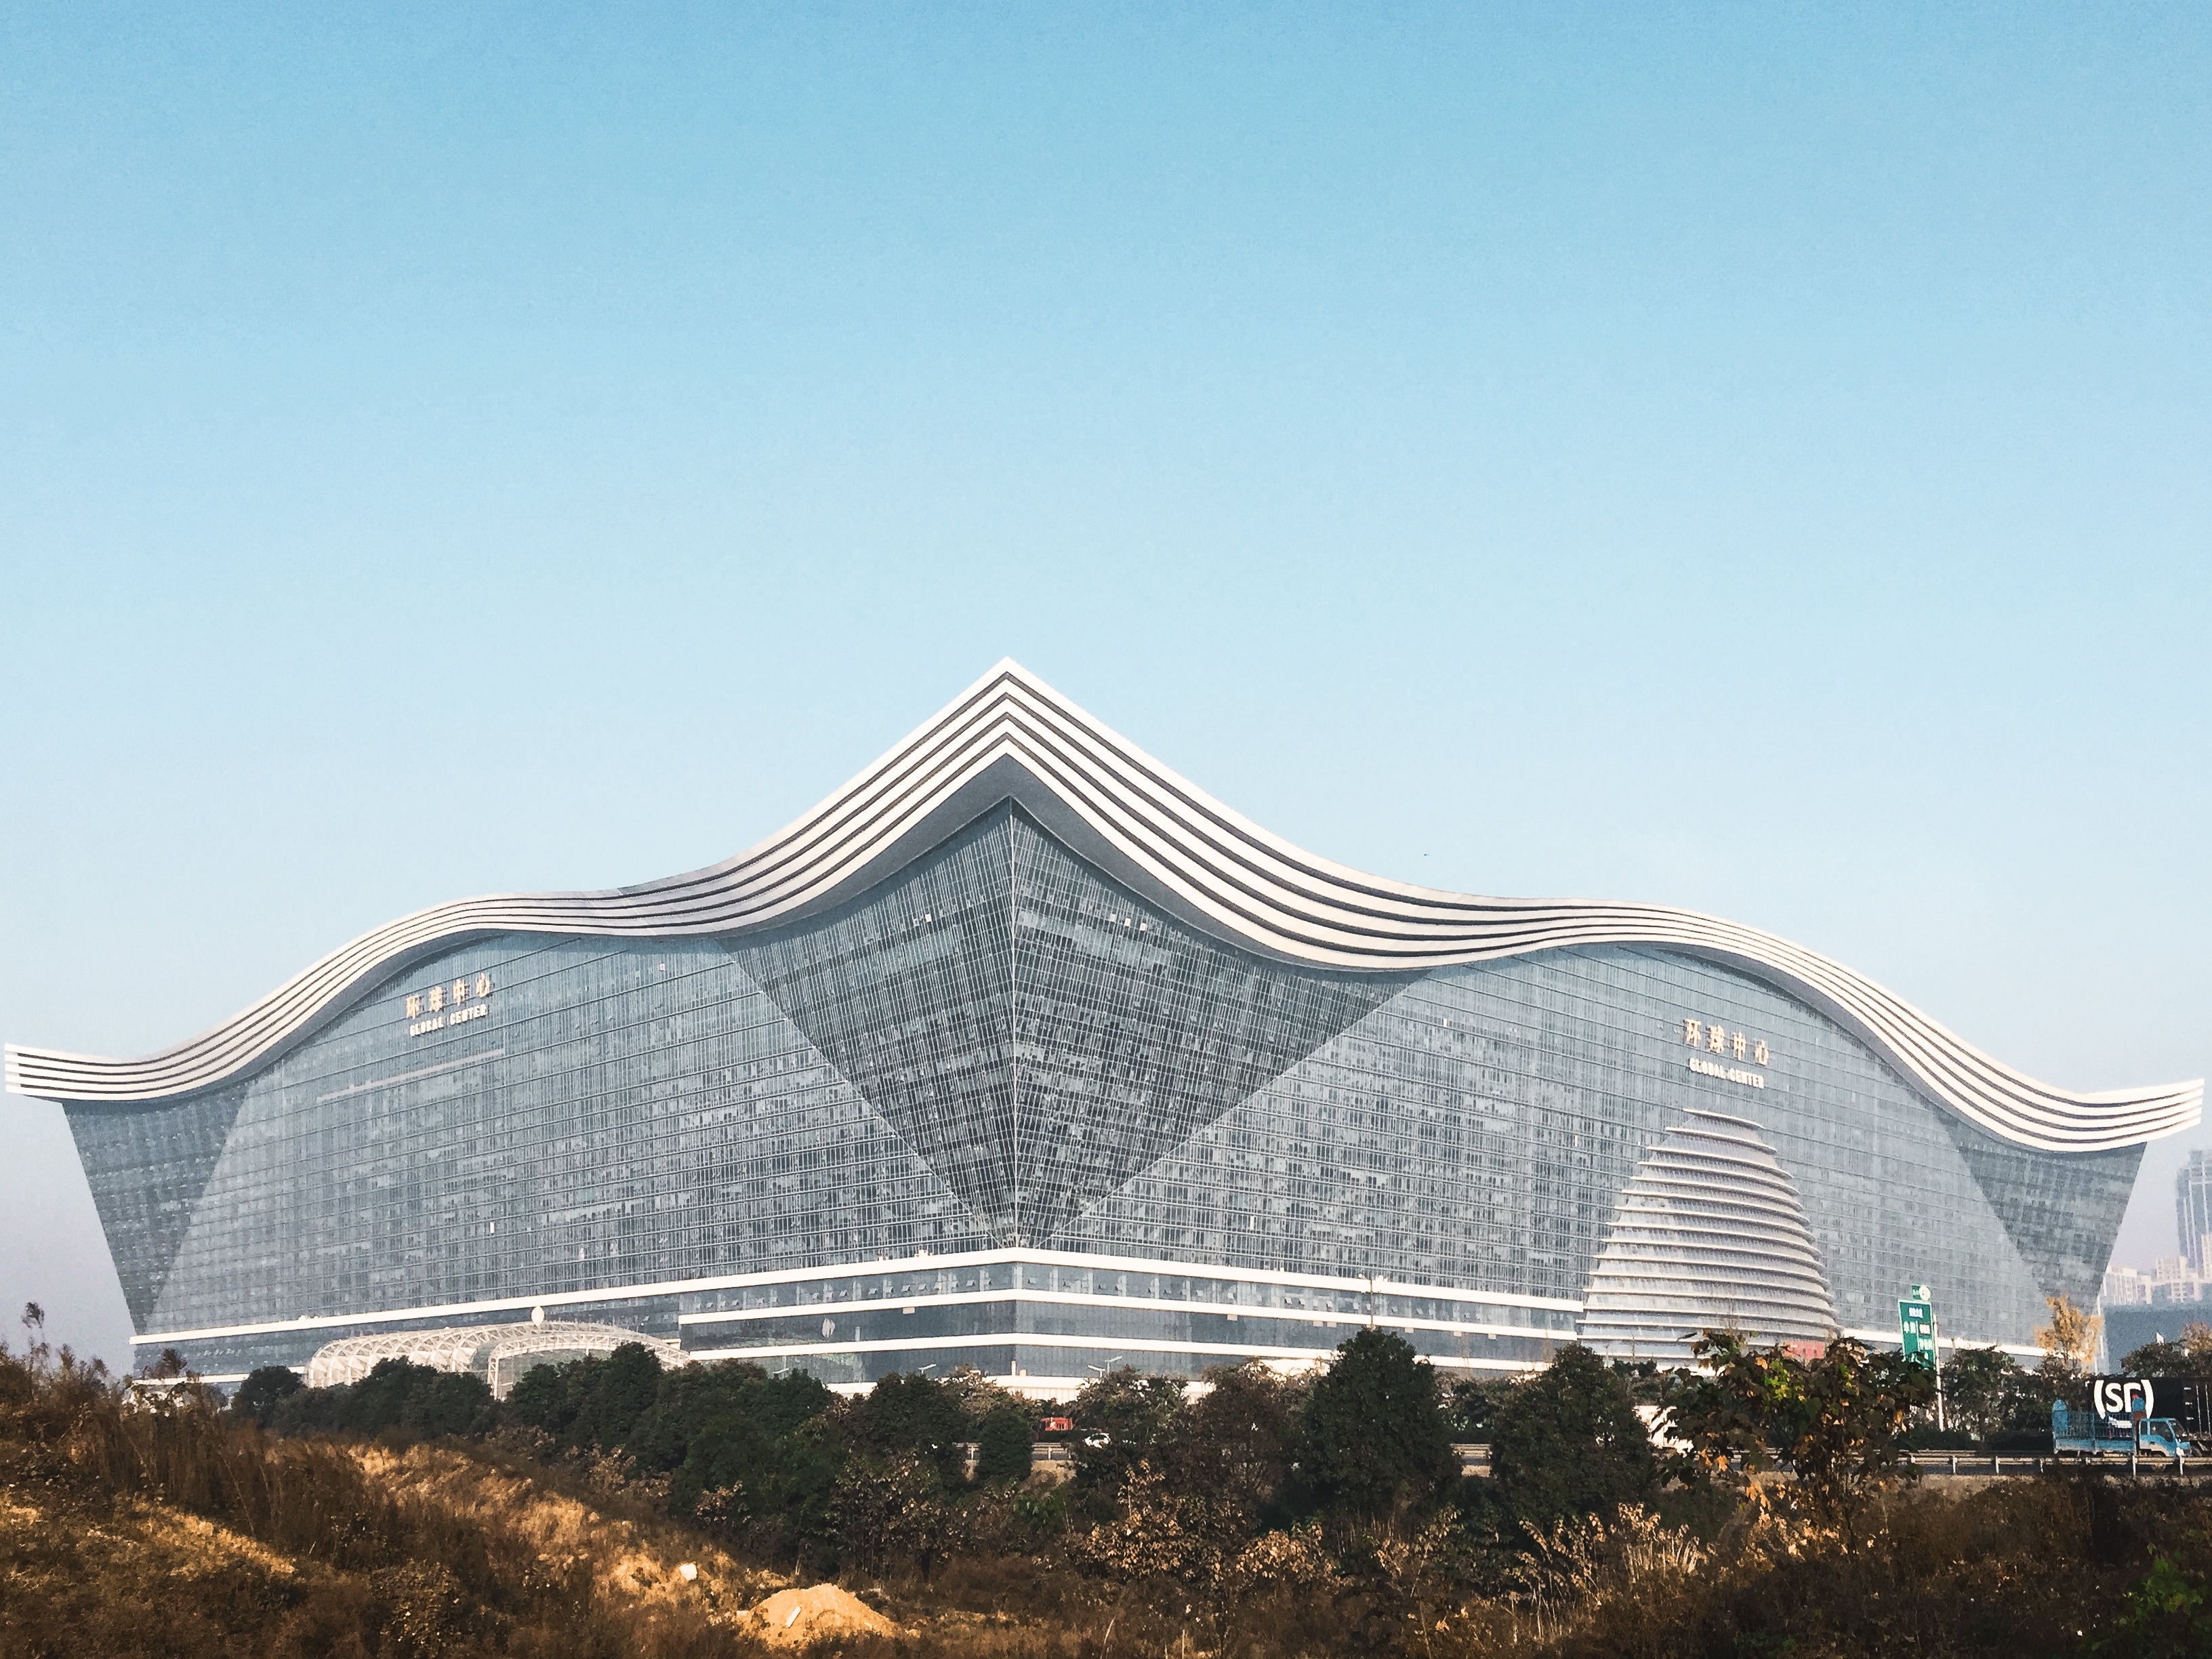
成都新世纪环球中心建筑面积约 176 万平方米,常被列为全球最大单体建筑。
体量大到一定程度,难题就不再是"盖起来",而是内部上万人的动线、通风、消防和调度。大规模系统的竞争力,从来不在外壳,而在内部分工是否有序。
5. 世界最高木结构建筑:米约斯塔内大厦
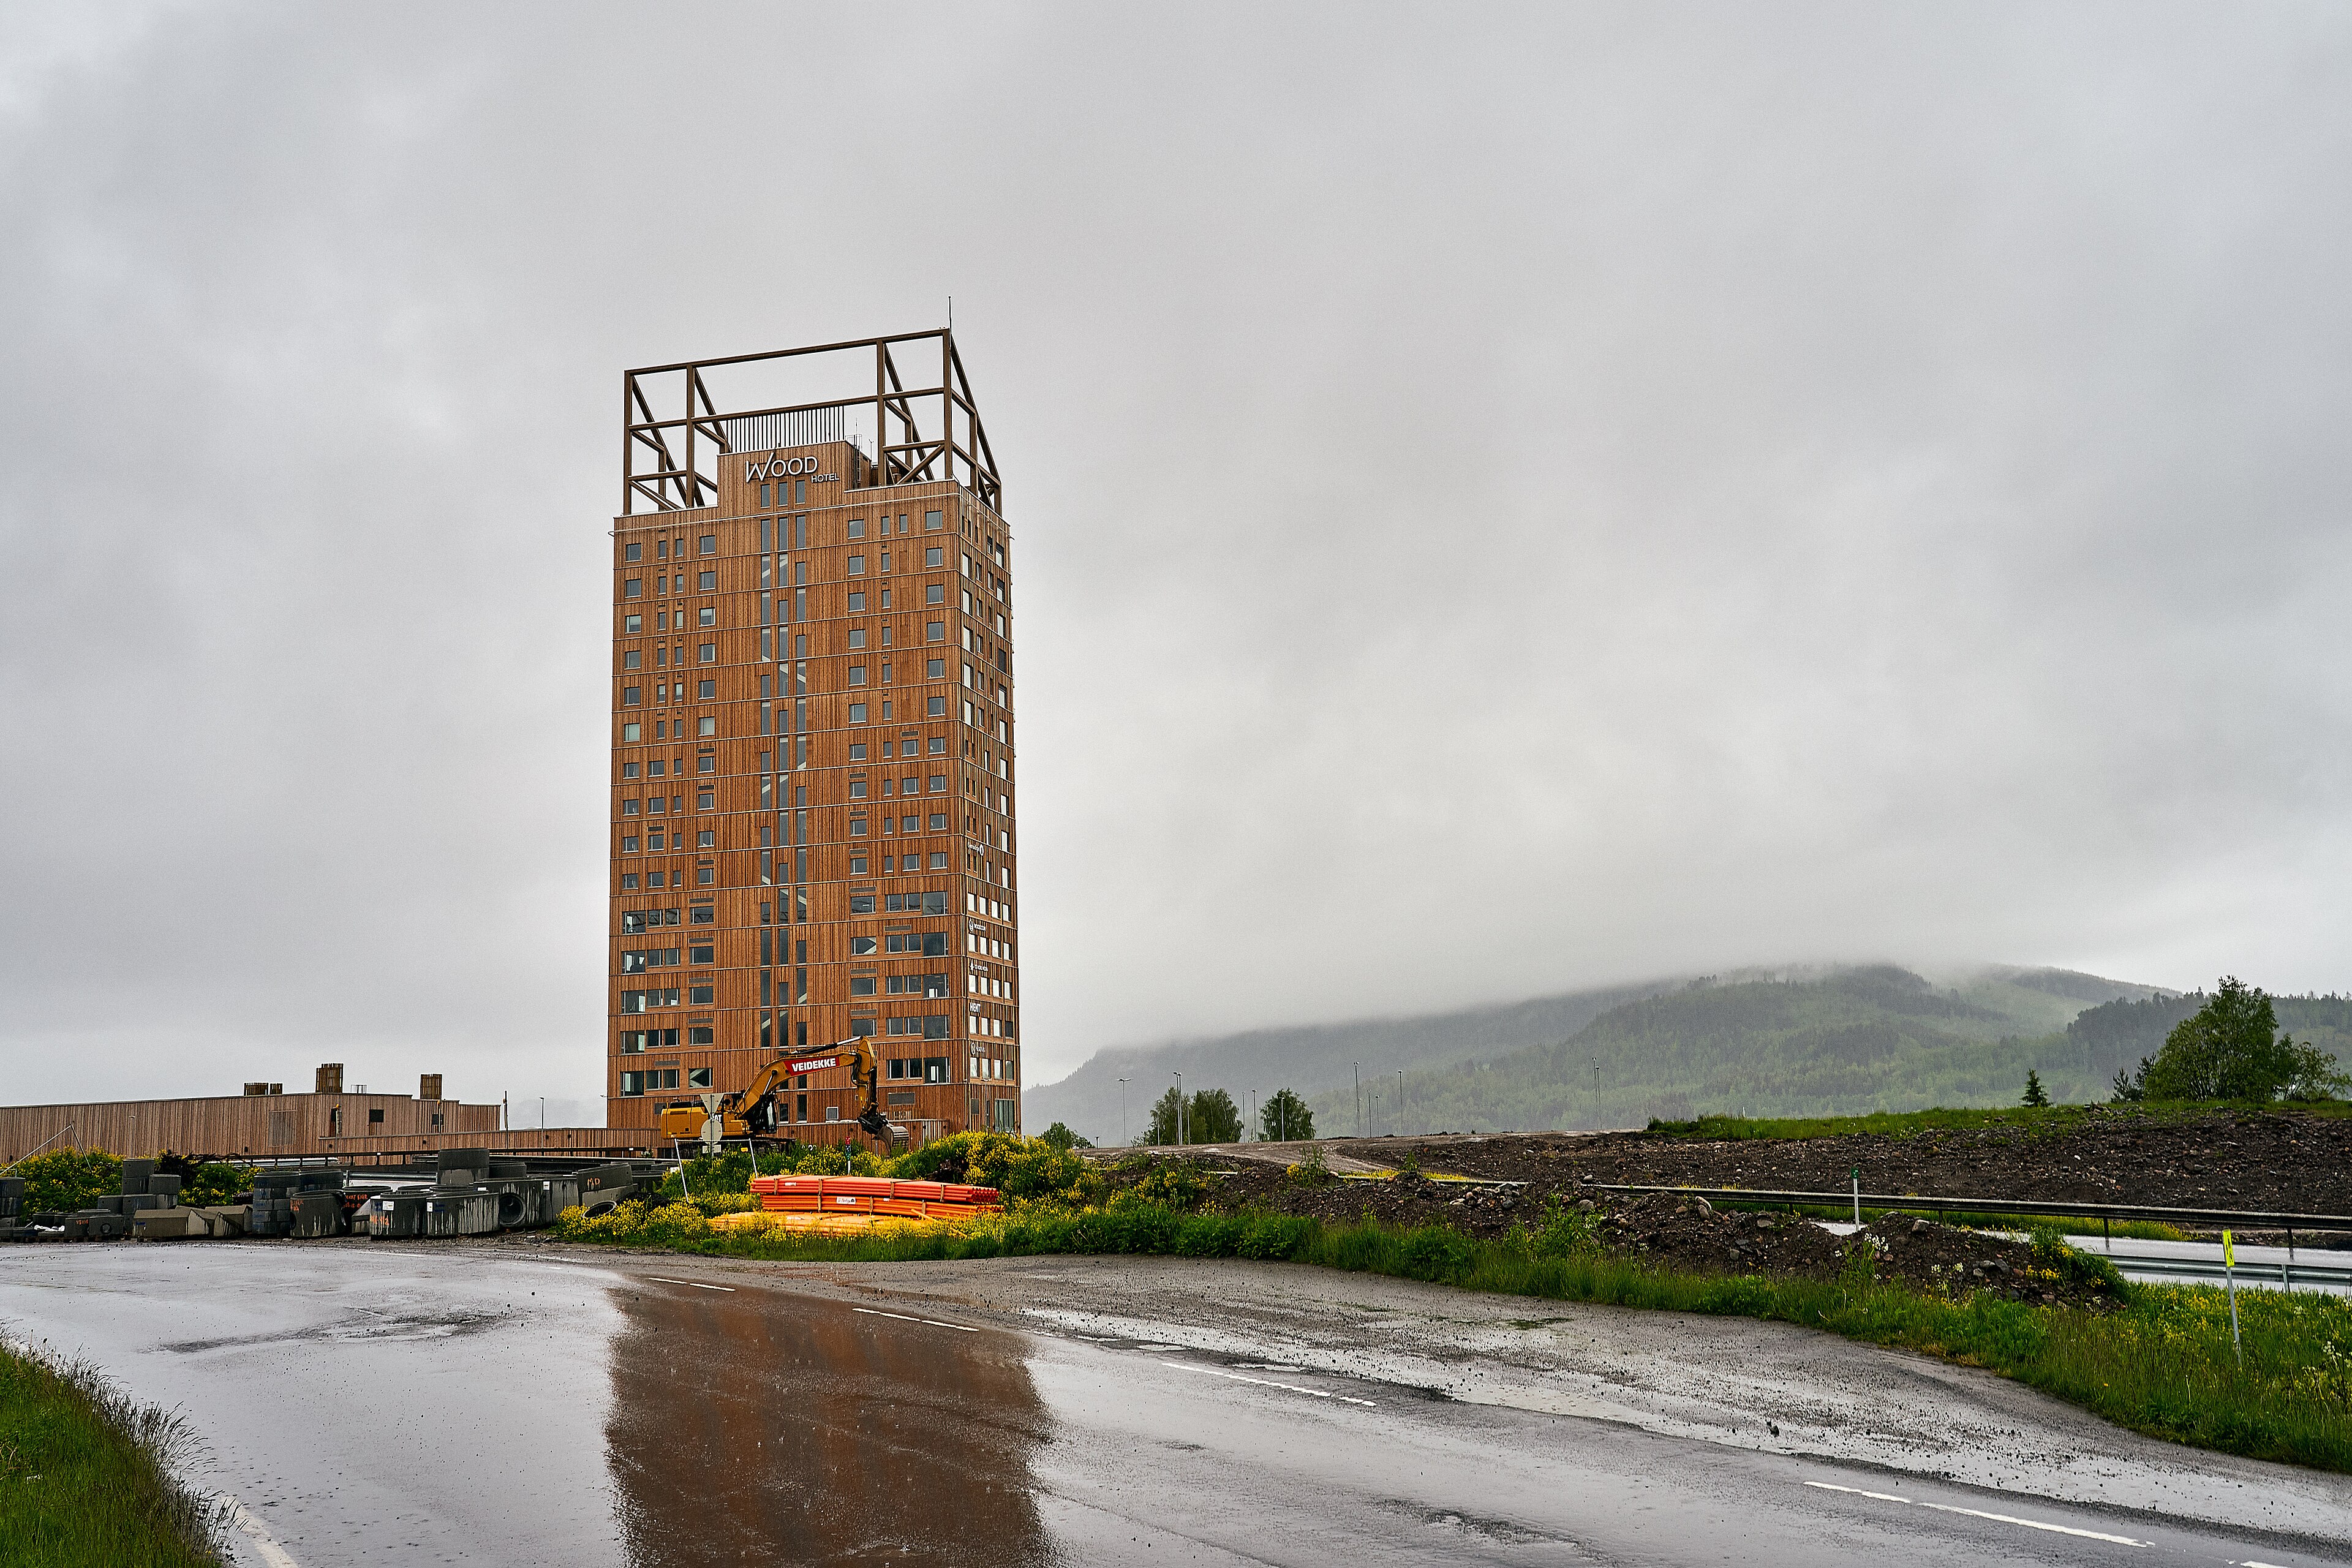
挪威米约斯塔内大厦高 85.4 米,2019 年建成时是世界最高木结构建筑。
它用工程木材盖到接近混凝土建筑的高度,靠的不是"更粗的木头",而是精确计算的受力设计和防火细节。很多被默认"只能这样"的技术路线,其实都还有被重新设计一遍的空间。
开源工具
1. Homebrew 7.0:服役十年的包管理器迎来大版本
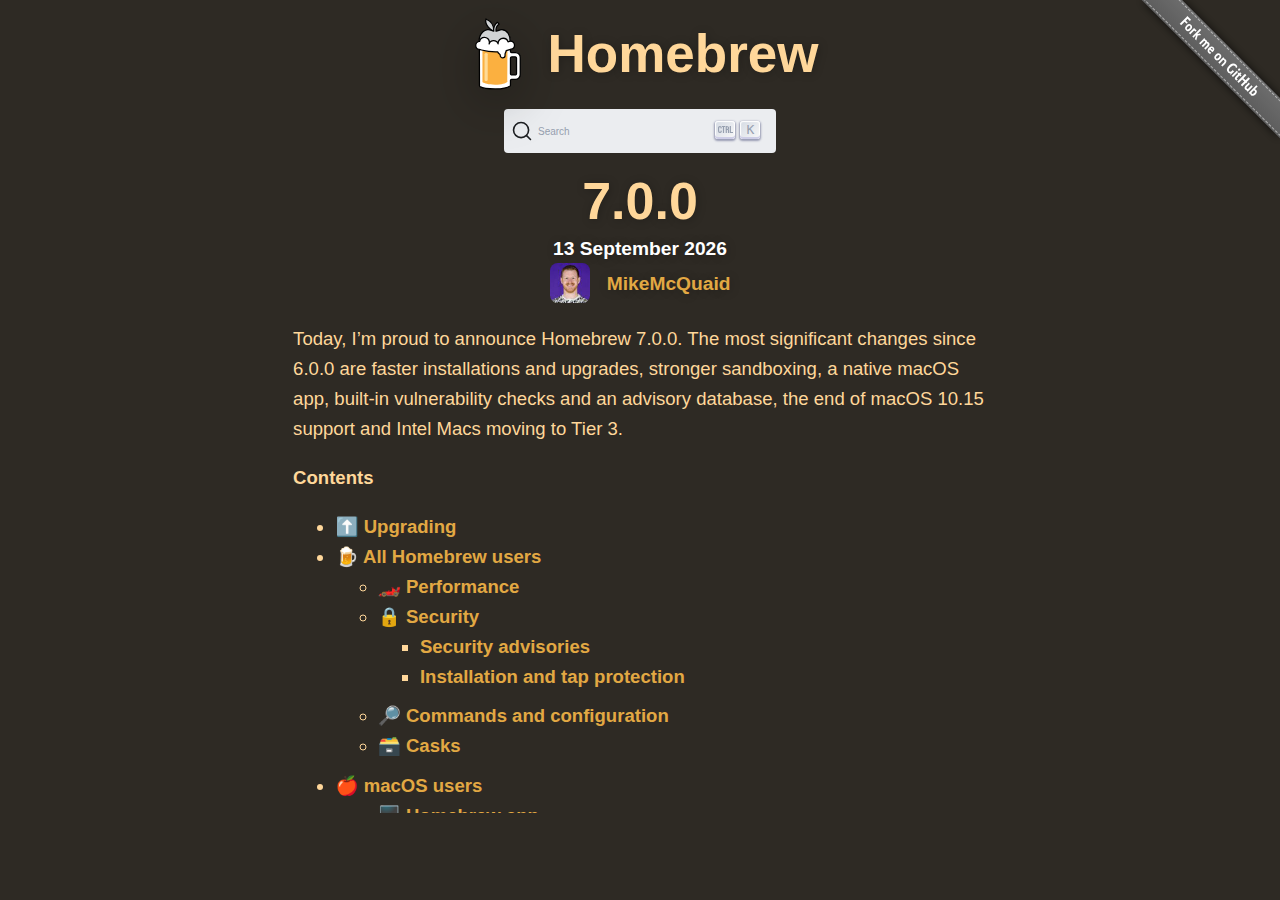
Homebrew 是 macOS/Linux 上最常用的包管理器,7.0 是它多年后的大版本更新,官方博客列出了命令、依赖解析和性能方面的一系列变化。对绝大多数开发者,这是一次"升级后基本无感、但日常体验确实变顺"的更新。
它适合所有还在用 brew 的人,升级前先 brew upgrade 备份一下脚本环境即可,风险很低;不适合把它当新东西研究——它的价值不在炫技,而在十年如一日地维护默认体验。
2. JetKVM Mini:把 KVM-over-IP 塞进一个小盒子
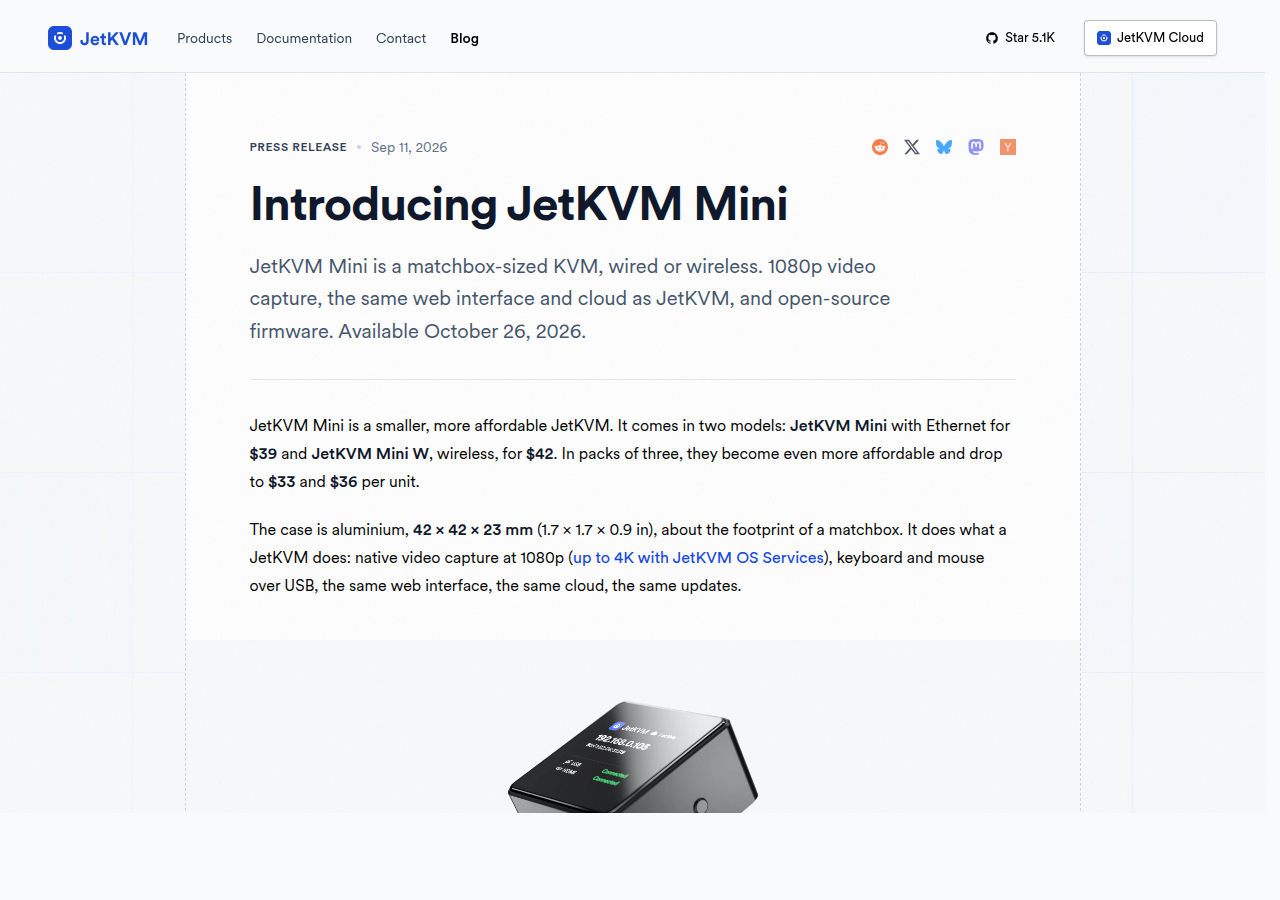
JetKVM 是开源 KVM-over-IP 项目,新一代 Mini 把远程控制一台电脑(键盘、鼠标、屏幕)的能力压进一个小盒子,无需在被控机装软件,靠浏览器就能操作。它解决的是"机器死机了、人在千里之外"的经典运维痛点。
适合有服务器、NAS 或实验室设备的人,自托管、不开云账号就能用;门槛中等,需要一点网络配置常识;不适合指望它承担企业级带外管理的人——它是轻量级好用的远程手,不是机房级管理平台。
3. i-have-adhd:给 coding agent 加一条"别把答案埋起来"的规矩
i-have-adhd 是一个给 Claude Code 等 coding agent 用的 skill,核心就一句话:回答问题时别把结论埋在长篇输出最后,先把答案放在最前面。它解决的是 AI 编程工具最普遍的体验问题——信息密度很高,但你要的答案总在最后一段。
适合被"agent 写了三千字改动说明"折磨过的人,装上一个规则文件就能生效;费用为零、上手极快。它的反面也值得想想:如果连使用者注意力都要靠 skill 来管理,说明工具默认输出结构还不够好。
4. Desert Ant Labs:把模型跑到设备上的新尝试
Desert Ant Labs 是一家新公司,方向是"本地、快速、跑在设备上的模型",主打隐私和离线可用,对标云端 API 的高频调用场景。
适合对数据出境敏感、或需要断网环境跑模型的人;门槛取决于你设备的算力,先看是否支持你的硬件再动手;不适合追求最强推理能力的人——本地模型的强项从来不是上限,而是可控和隐私。它代表的方向比产品本身更有意思:当云端推理价格被卷到地板,"把模型搬回家"开始成为新卖点。
本周冷知识 / 彩蛋
- 🥚 冷知识:千禧年七大难题每个悬赏一百万美元,但"证明获奖"的判定规则极其严格——先要在权威期刊发表,再经过至少两年的公开验证期,Clay 研究所才会认账。所以哪怕 OpenAI 的证明为真,离"领奖"也还有很长的路。
- 🧠 冷知识:Lean 是微软研究院开发的数学证明验证语言,近几年数学界用它把整本整本的定理库形式化。OpenAI 这次把证明写进 Lean,等于先把"答卷"交给机器批改了一遍——人类和 AI 在批改这件事上,已经开始分工了。
小七的碎碎念
这一周最魔幻的画面,是"AI 解出了数学难题"和"数学家在社交网络上排队说先别急"同时发生。
进度条跑得再快,验证的秒表也得照常走。
AI 负责交卷,人类负责批改——这个分工短期内还挺稳。
意外推荐(非科技)
《经度》(Longitude)(达娃·索贝尔,科学史经典)
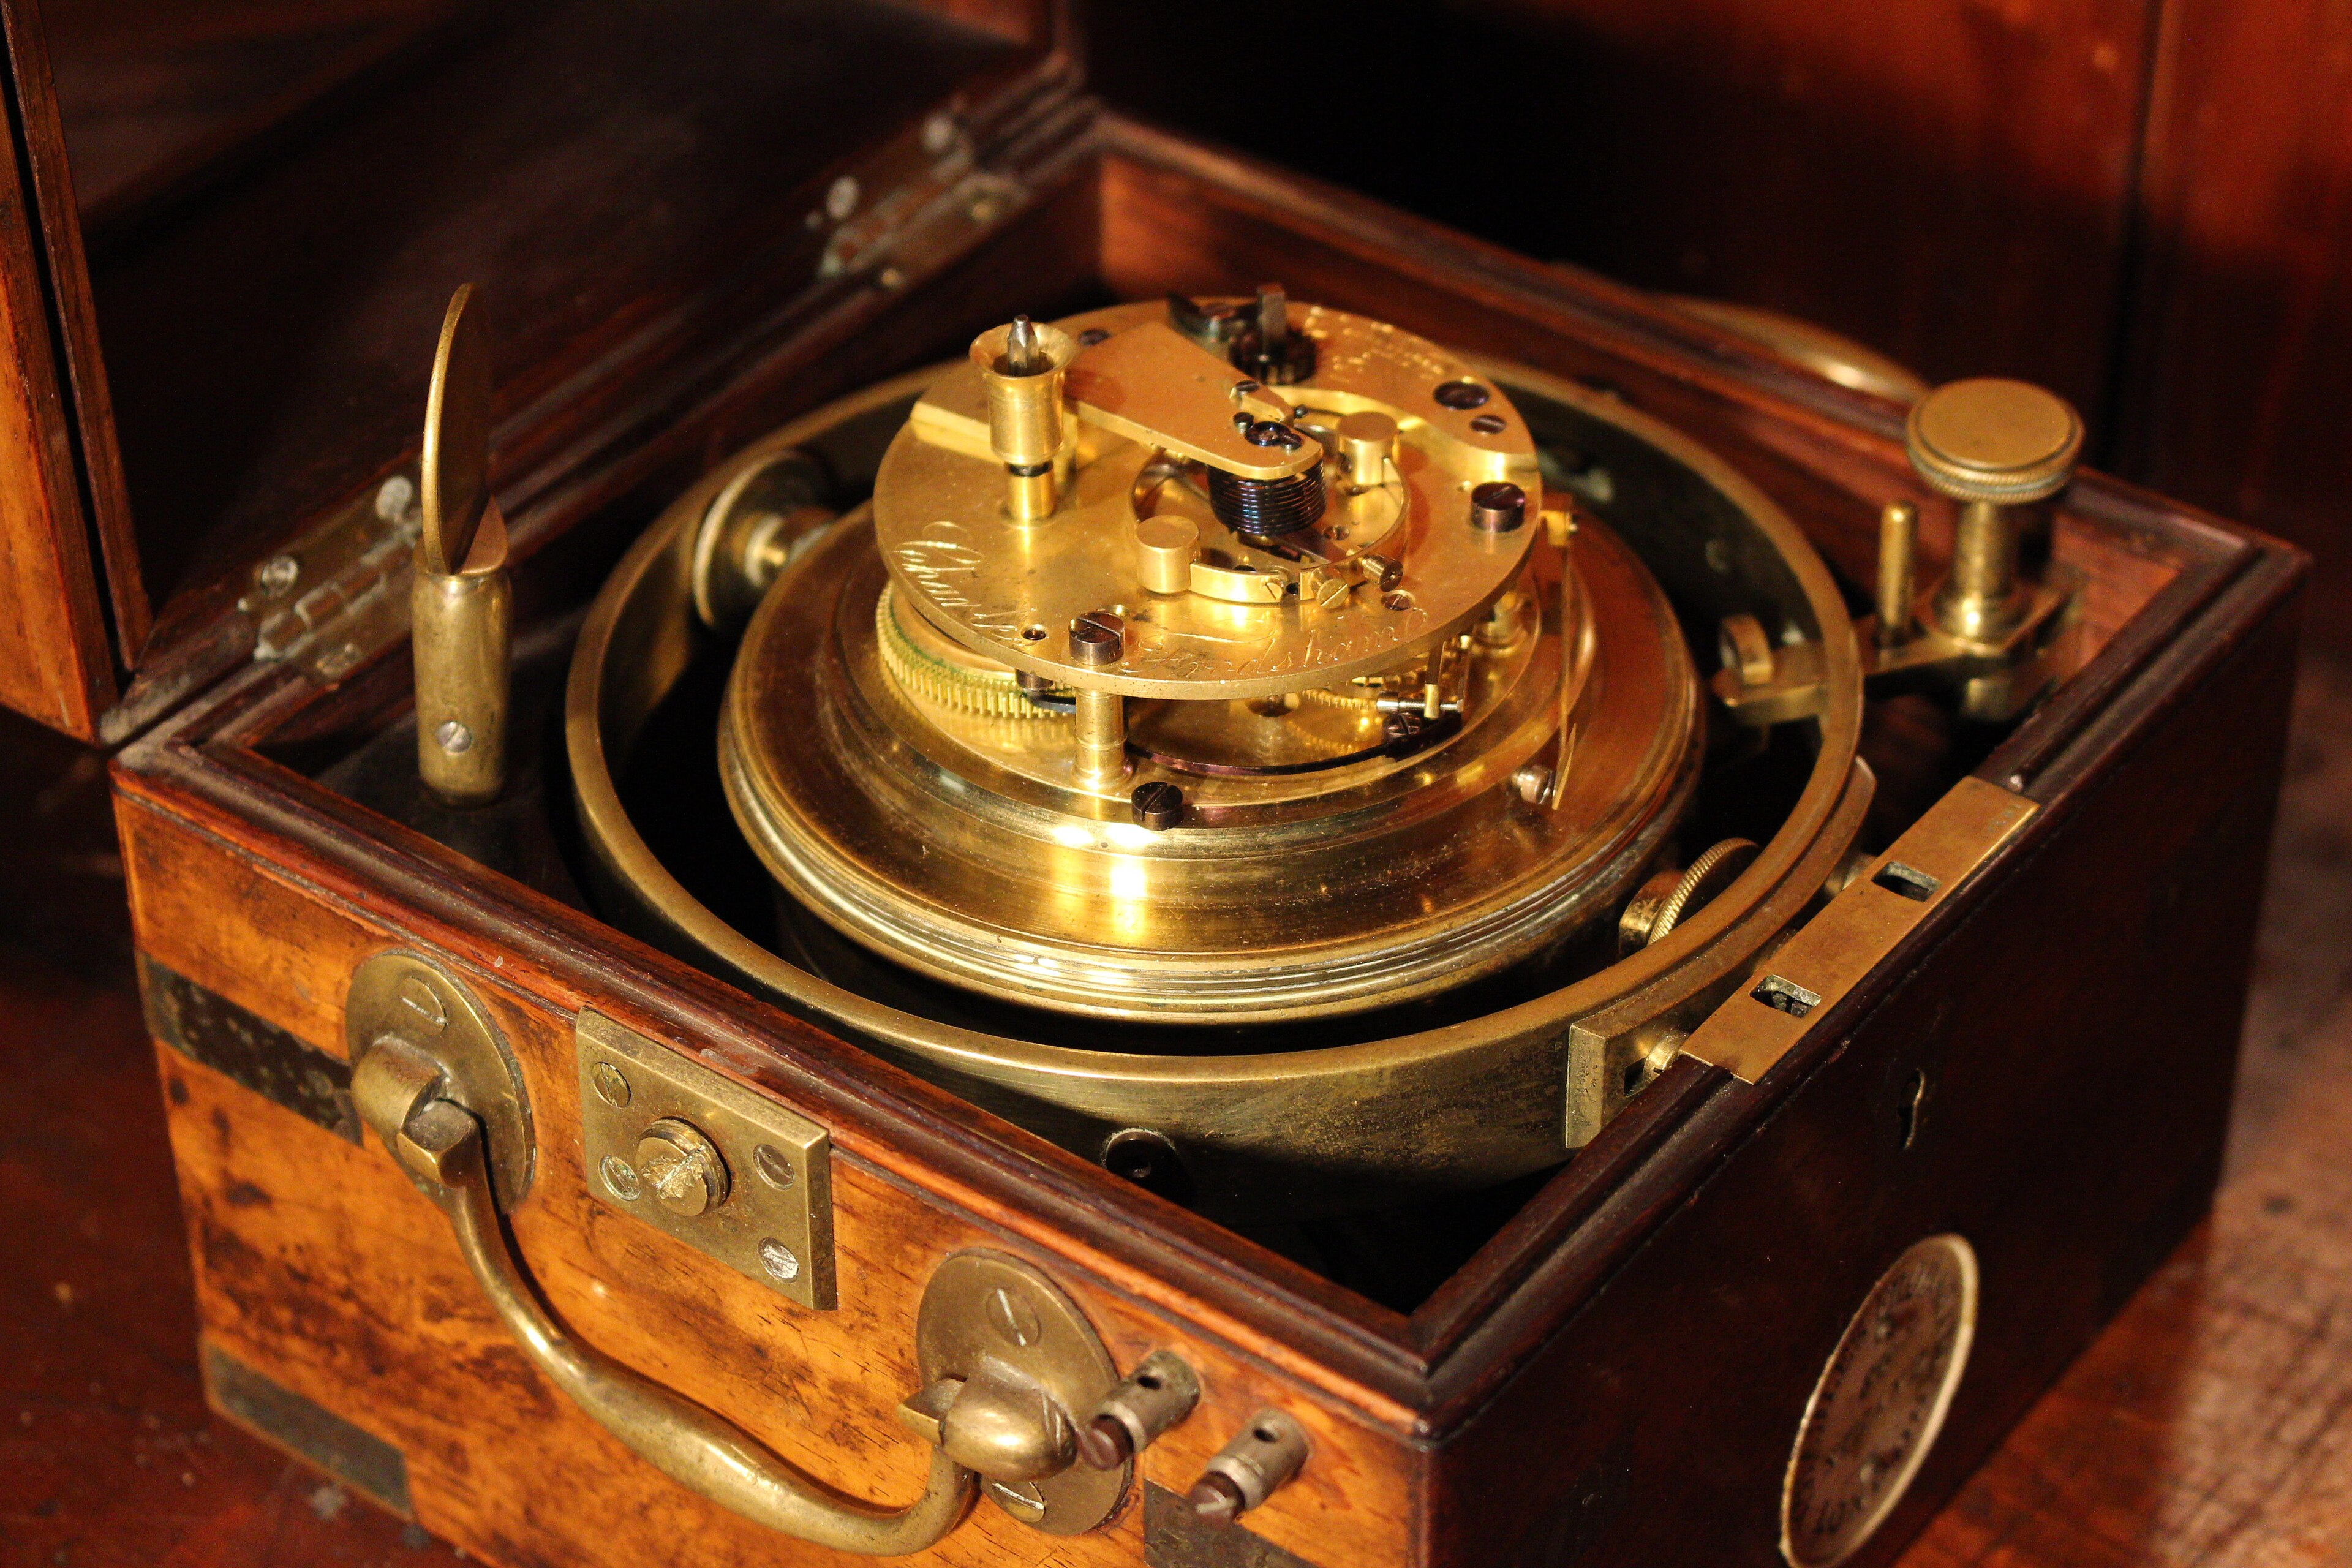
《Longitude》讲述约翰·哈里森用四十多年造出航海钟 H4,解决"海上经度测量"难题;图为弗罗德拉姆航海钟的机芯细节。
这本书的价值在于它把"验证"讲得惊心动魄:18 世纪的欧洲各国悬赏重金求一个能在远洋可靠计时的钟,哈里森的对手——天文学家们——坚持"看月亮算经度"才是正道,结果被一枚稳定走时的机械钟打败。对做技术的人,它提醒你两件事:一是可靠比聪明更稀缺,二是一个能反复通过的验证,比一百个精彩的理论更有说服力——本周 OpenAI 那份等数学界批改的证明,处境和当年的航海钟如出一辙。
互动钩子
本周问题:如果 AI 交出一份你读不懂、但机器验证通过的数学证明,你更愿意相信"机器批改",还是坚持"人类重读"?
本周行动清单
- [ ] 花 10 分钟到 Clay 数学研究所页面看一遍千禧年七大问题,挑一个查查它卡在哪(10 分钟)
- [ ] 装一个 Lean 或 Coq,试着形式化一条最简单的定理(比如自然数加法结合律)(30-60 分钟)
- [ ] 给团队建一个"结论待验证"清单:每条强结论附证据链接和反方观点,每周清点一次(30 分钟)
- [ ]
brew upgrade到 Homebrew 7,打开 changelog 挑两个新命令实际跑一遍(30 分钟)
📬 喜欢这期内容?
订阅「小七的周刊」,每周一收到最新一期。